Одного фото достаточно, чтобы ИИ скопировал ваш голос
Представьте: вы загружаете в нейросеть обычную фотографию своего лица. Никаких записей голоса, никаких аудиосэмплов. Просто фото. А на выходе получаете видео, где звучит голос, практически неотличимый от вашего настоящего. Фантастика? Нет, это реальность, которая продержалась ровно до того момента, пока все не осознали масштаб проблемы.
В начале февраля китайская ByteDance выпустила свой генератор видео Seedance 2.0. Штука мощнейшая. Принимает на вход до 12 файлов одновременно: изображения, видео, аудио и текст. Модель умеет воспроизводить работу камеры из загруженных эталонных роликов, подменять персонажей, достраивать существующие клипы. Всё это в разрешении 2K, с автоматическим наложением звуковых эффектов и музыки. Архитектура на основе двухканального диффузионного трансформатора генерирует картинку и звук одновременно.
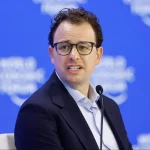
Звучит как мечта любого креатора, правда? И вот тут начинается самое интересное. Основатель технологического издания MediaStorm Пан Тяньхун, загрузил в систему свою фотографию — и модель выдала аудио, почти идентичное его реальному голосу. Без единого голосового сэмпла. Без какой-либо авторизации. Просто по фото. Я не знаю, как они это делают, не нашёл информации.
Масштаб угрозы очевиден: дипфейк-новости, мошенничество, шантаж. И всё это в пару кликов. И теперь платформа Jimeng, как Seedance называется в Китае, экстренно заблокировала эту возможность. Использовать фотографии реальных людей в качестве эталонных объектов. А приложения Jimeng и Doubao от ByteDance ввели обязательную верификацию. Теперь перед созданием цифрового аватара нужно записать собственное изображение и голос.
Ситуация с Seedance 2.0 — это момент, когда технология буквально обогнала этику. Швейцарская консалтинговая компания CTOL назвала модель Seedance 2.0 сильнейшей в мире, обогнавшей Sora 2 и Veo 3.1. И деньги инвесторов потекли в китайские медиаакции за несколько часов. После релиза Seedance 2.0 акции китайских медиакомпаний подскочили на 15 процентов за день. Видимо, производство контента подешевеет в тысячи раз, что убьёт средний сегмент видеопродакшена. И проиграли тут все, кто строил бизнес на «среднем» уровне визуальных эффектов. Одновременно должен сильно расти рынок верификации и детекции дипфейков.
Но в целом дипфейк-мошенничество уже принесло убытков на 1.1 миллиарда долларов только в США за 25-й год. Втрое больше, чем годом ранее. А к 27-му году Deloitte прогнозирует 40 миллиардов. И это было ещё до появления инструмента от Seedance 2.0, который клонирует голос по одному фото.