
Отец обучения с подкреплением предрек конец эры больших языковых моделей
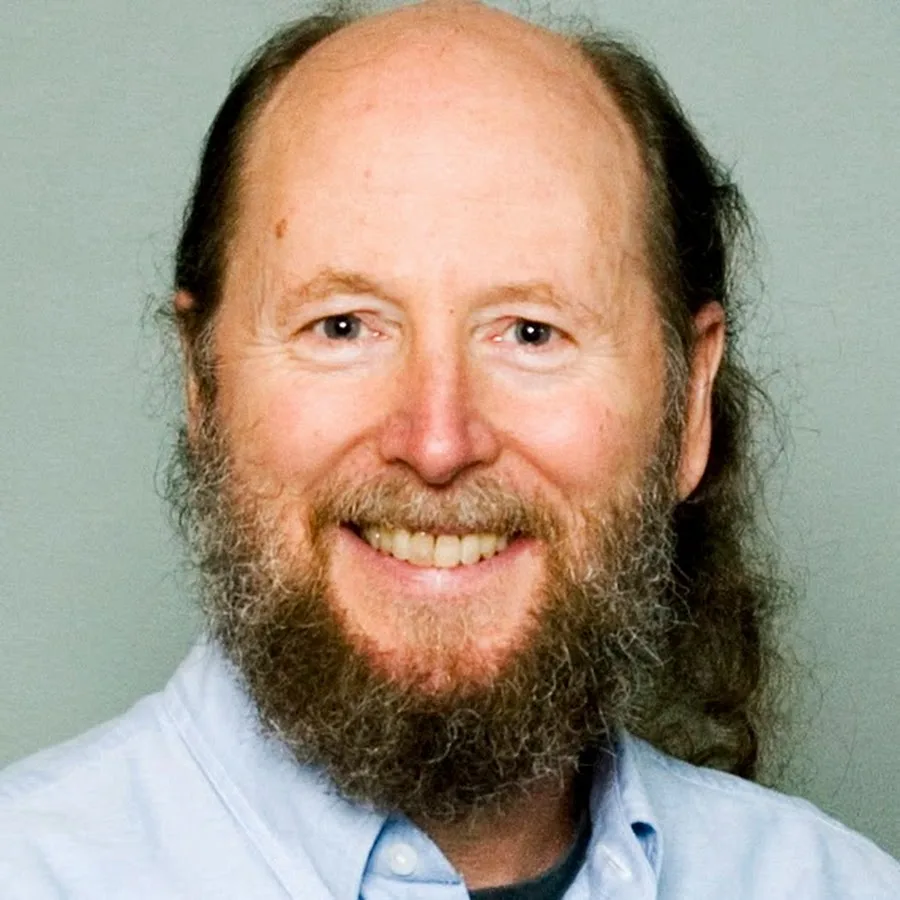
Ричард Саттон — это 1 из отцов обучения с подкреплением и лауреат премии Тьюринга. Так вот он заявил, что эпоха больших языковых моделей подходит к концу. Дальше, по его мнению, наступает эра опыта. И вот почему он так считает.
По его мнению, большие языковые модели — это тупик. Настоящий интеллект должен учиться на опыте, а не на данных. А современные нейросети — это только имитация интеллекта. Они не имеют опыта, не совершают действий и не получают обратной связи от реальности. Поэтому они не способны к настоящему познанию.
По мнению Саттона, человечество создаёт новую форму жизни, основанную на проектировании, а не биологическом размножении. А мы становимся свидетелями перехода от мира, где всё копируется, к миру, где всё проектируется.
Живые существа — это репликаторы, а искусственный интеллект — проектировщики, объясняет он. Мы можем создать системы, которые будут создавать другие системы, и всё это путём конструирования, а не копирования. По его словам, это новый этап эволюции Вселенной.
Получается, что Саттон смотрит на текущий бум больших языковых моделей как на временное явление. Настоящий прорыв, по его мнению, случится тогда, когда системы искусственного интеллекта начнут учиться через взаимодействие с реальностью, получая обратную связь от своих действий. Не через поглощение терабайтов текста, а через настоящий опыт. Как это делают живые существа.
Вот вам и взгляд 1 из основоположников современного машинного обучения на будущее технологии. Получается, большие языковые модели — это не финал, а всего лишь промежуточный этап.




